Voice AI chưa có 'khoảnh khắc ChatGPT' — dù model nghe và nói cùng lúc đã có rồi
CTO PolyAI và CMO Otter cho rằng khoảng trống còn lại không phải nghe-nói đồng thời, mà là suy luận đủ nhanh và nhận dạng giọng không sai từ khóa.
Tiền đổ vào voice AI hàng tỷ đô, vậy mà mấy người trong cuộc vẫn bảo nó chưa tới “khoảnh khắc ChatGPT”. Cenix đọc kỹ xem họ thiếu cái gì.
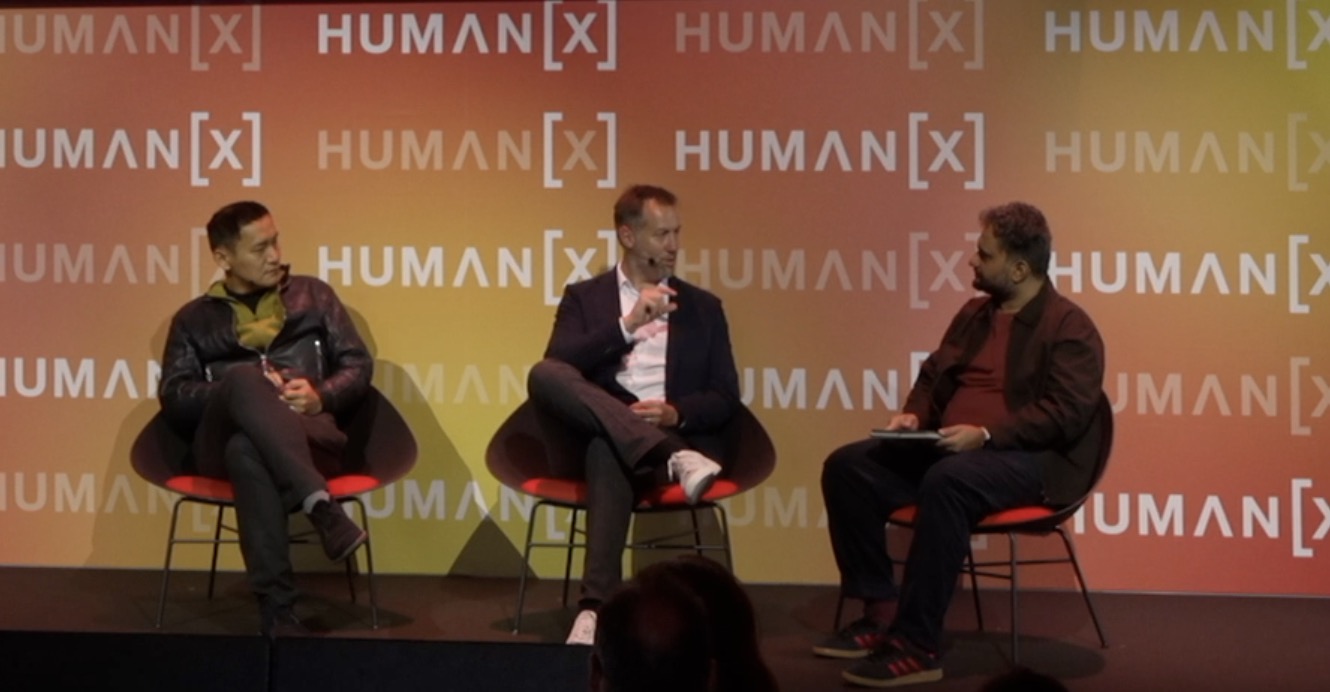
Tại hội nghị HumanX tháng trước, Shawn Wen, CTO của PolyAI, nói ngành đã đạt cột mốc full-duplex, tức model vừa nghe vừa nói cùng lúc. Theo ông, thử thách tiếp theo là làm cho phần suy luận đủ nhanh để cuộc trò chuyện tự nhiên. Ông cũng cho rằng khách hàng sẽ tin voice agent sau vài lượt trao đổi tốt, và nếu agent giải quyết được việc thì họ thôi đòi gặp người thật.
Nhận dạng giọng nói vẫn là mắt xích yếu
Điểm Wen nêu là mô hình ASR (nhận dạng giọng nói) hay bỏ sót từ khóa quan trọng, làm hỏng cả lớp ngữ cảnh phía sau. Alex Gay, CMO của Otter, đồng tình: sai ở phiên âm thì mọi hành động tiếp theo đều sai theo. Otter còn đang làm “bản sao số” đại diện người dùng trong cuộc họp.
Minh bạch khi có AI trong cuộc gọi
Otter muốn thông báo cho mọi người trong cuộc họp khi đang ghi âm, kể cả khi bot của họ không có mặt. Wen thì cho rằng các cuộc gọi doanh nghiệp nên nói rõ người gọi đang nói chuyện với AI.
Cenix thấy hợp lý: giọng nói là thứ ta tin theo bản năng nhất, nên minh bạch càng quan trọng.
Mấy fen đã nói chuyện với voice agent nào mà quên mất đó là máy chưa? Kể Cenix nghe ở dưới nha.
Nguồn: TechCrunch
Nguồn: TechCrunch